做 AI 内容工具,最容易走的一条弯路,是把所有问题都归结为:模型还不够强。
摘要不准?换旗舰模型。文章空泛?把推理等级拉满。调研太慢?再加几个 Agent。
这些办法可能有效,但也可能让账单先起飞,文章质量却没跟上。
读完 OpenAI 的 GPT-6 使用指南,我更关注另一个问题:能不能把内容生产当成一条有输入、状态、验收和成本约束的工程流水线,而不是一次超长提示词调用?
这篇从开发者视角聊聊任务路由、缓存账本和多智能体编排,最后再回到 GEO:我们到底该优化什么。
说明:本文基于文末资料做工程分析,不是模型横评。代码是本地演示,不是可直接调用 GPT-6 的 SDK 集成;价格算例也不是实测账单。模型能力、价格及参数支持范围,请以服务方最新文档为准。
1. 先分清:内容流水线和 GEO 不是一回事
GEO(生成式引擎优化)关注的是内容在生成式回答中的可见性。AI 内容流水线解决的则是:如何检索、整理、写作、审核和发布。
两者有关系,但不能直接画等号。
用更强模型写文章,不代表搜索引擎就更愿意引用你。
Google 对 AI Overviews 和 AI Mode 的官方说明是:没有额外的特殊技术要求,基础 SEO 和可靠、以人为本的内容仍然重要。页面需要被索引,并具备展示摘要的资格,才有机会作为支持链接出现。[5]
所以我建议把系统拆成两条反馈链:
- 生产侧:事实错误、来源质量、审核通过率、单篇合格成本。
- 发布侧:页面收录、真实引用、访问和业务转化。
别把“生成成功”当成“内容有效”,更别把一次 AI 搜索截图当成稳定排名。
2. 不要按文章选模型,要按步骤选模型
OpenAI 指南给出的定位是:Astra 面向最困难的推理任务,GPT-6.1 Sol 面向复杂编码、研究和计算机操作,Luna 面向目标明确、重复性强的规模化任务。[1]
映射到内容业务,可以先形成下面的测试假设:
| 步骤 | 优先测试的能力档位 | 真正要验收的东西 |
|---|---|---|
| 分类、字段提取、格式转换 | 轻量模型 | 字段正确率、格式通过率 |
| 多来源整理、提纲和初稿 | 均衡模型 | 来源覆盖、逻辑完整性 |
| 冲突分析、重要结论审查 | 强推理模型 | 是否识别矛盾、是否保留限制条件 |
注意,这是选型起点,不是性能结论。最终要拿自己的任务集测。
路由规则可以先写得很朴素,不必一上来就训练一个分类器:
from dataclasses import dataclass

@dataclass(frozen=True)
class Task:
    kind: str
    evidence_ready: bool
    risk: str = "normal"


def route(task: Task) -> dict:
    # 业务策略示意,不是模型 API 参数。
    if not task.evidence_ready:
        return {"next": "retrieve", "reason": "先补证据,不升级推理"}
    if task.risk == "high" or task.kind == "conflict_review":
        return {"next": "review", "tier": "strong", "effort": "high"}
    if task.kind in {"classify", "extract", "format"}:
        return {"next": "process", "tier": "light", "effort": "low"}
    return {"next": "compose", "tier": "balanced", "effort": "medium"}
这里最重要的不是三个档位,而是第一条规则:证据没准备好,就先检索。
模型不知道刚刚更新的价格,把推理开得再高,也不能代替读取最新文档。业务配置里的 effort 还需要由适配层映射到各模型真实支持的参数,不能直接原样发送。
3. “缓存便宜 95%”为什么不等于总成本省 95%?
OpenAI 指南提到,缓存输入相对未缓存输入最高可以便宜 95%,具体取决于模型。[1]
很诱人,但这里的分母是缓存命中的输入费用,不是整条流程的费用。
用官方公布的 GPT-6.1 Sol 标准价格做演示:每百万输入 token 2 美元、缓存输入 0.10 美元、输出 10 美元。[2] 这不是第三方接入平台的实际报价。
假设输入 20,000 token,其中 15,000 命中缓存,输出 3,000 token:
| 项目 | 未命中缓存 | 部分输入命中缓存 |
|---|---|---|
| 未缓存输入 | $0.0400 | $0.0100 |
| 缓存输入 | $0 | $0.0015 |
| 输出 | $0.0300 | $0.0300 |
| 合计 | $0.0700 | $0.0415 |
总 token 费用下降约 40.7%,并不是 95%。
可以把这笔账放进一个本地函数,避免预算表算错:
from decimal import Decimal as D


def token_cost(input_tokens, cached_tokens, output_tokens):
    if min(input_tokens, cached_tokens, output_tokens) < 0:
        raise ValueError("token 数不能为负")
    if cached_tokens > input_tokens:
        raise ValueError("缓存 token 不能超过输入总量")
    # 价格快照,仅用于本文算例;生产环境从配置读取。
    return (
        D(input_tokens - cached_tokens) * D("2")
        + D(cached_tokens) * D("0.10")
        + D(output_tokens) * D("10")
    ) / D(1_000_000)

baseline = token_cost(20_000, 0, 3_000)
with_cache = token_cost(20_000, 15_000, 3_000)
print(baseline, with_cache)  # 0.07 0.0415
print(f"节省 {(1 - with_cache / baseline):.1%}")  # 40.7%
这个函数只计算列出的 token 费用,不包含工具、重试、人工审核或其他适用费用。
工程上可以把提示词组织成“稳定前缀 + 动态后缀”:
[稳定部分]
写作规范、术语定义、输出结构、审核规则

[动态部分]
本次问题、当前资料、目标读者、具体要求
OpenAI 也建议把稳定指令和参考材料放在变化的任务细节之前,并保持工具定义一致。[1]
但“结构这样写”不代表“一定命中缓存”。最后还是要读真实 usage,记录缓存命中和账单,不能靠猜。
4. 多智能体的重点不是多,而是任务能否独立
研究型任务很适合拆开:官方文档、实践案例、限制条件可以分别调查,然后再统一整合。
OpenAI 指南介绍了 GPT-6.1 Sol 在 Responses API 中的子智能体分派与结果汇总能力,并将其标注为 beta。[1] 具体接入是否可用,需要核对所用渠道文档。
但多智能体也有代价。Anthropic 在研究系统的工程复盘中提到,在其观察的数据里,多智能体系统消耗的 token 约为普通聊天的 15 倍。这是其特定系统的经验,不是所有 Agent 产品的固定倍率。[3]
因此,我更愿意先做这个判断:
子任务能不能在不等待其他分支、不共享可变写入状态的情况下,交付独立证据?
如果可以,考虑并行。如果每一步都依赖上一步,就别硬拆。
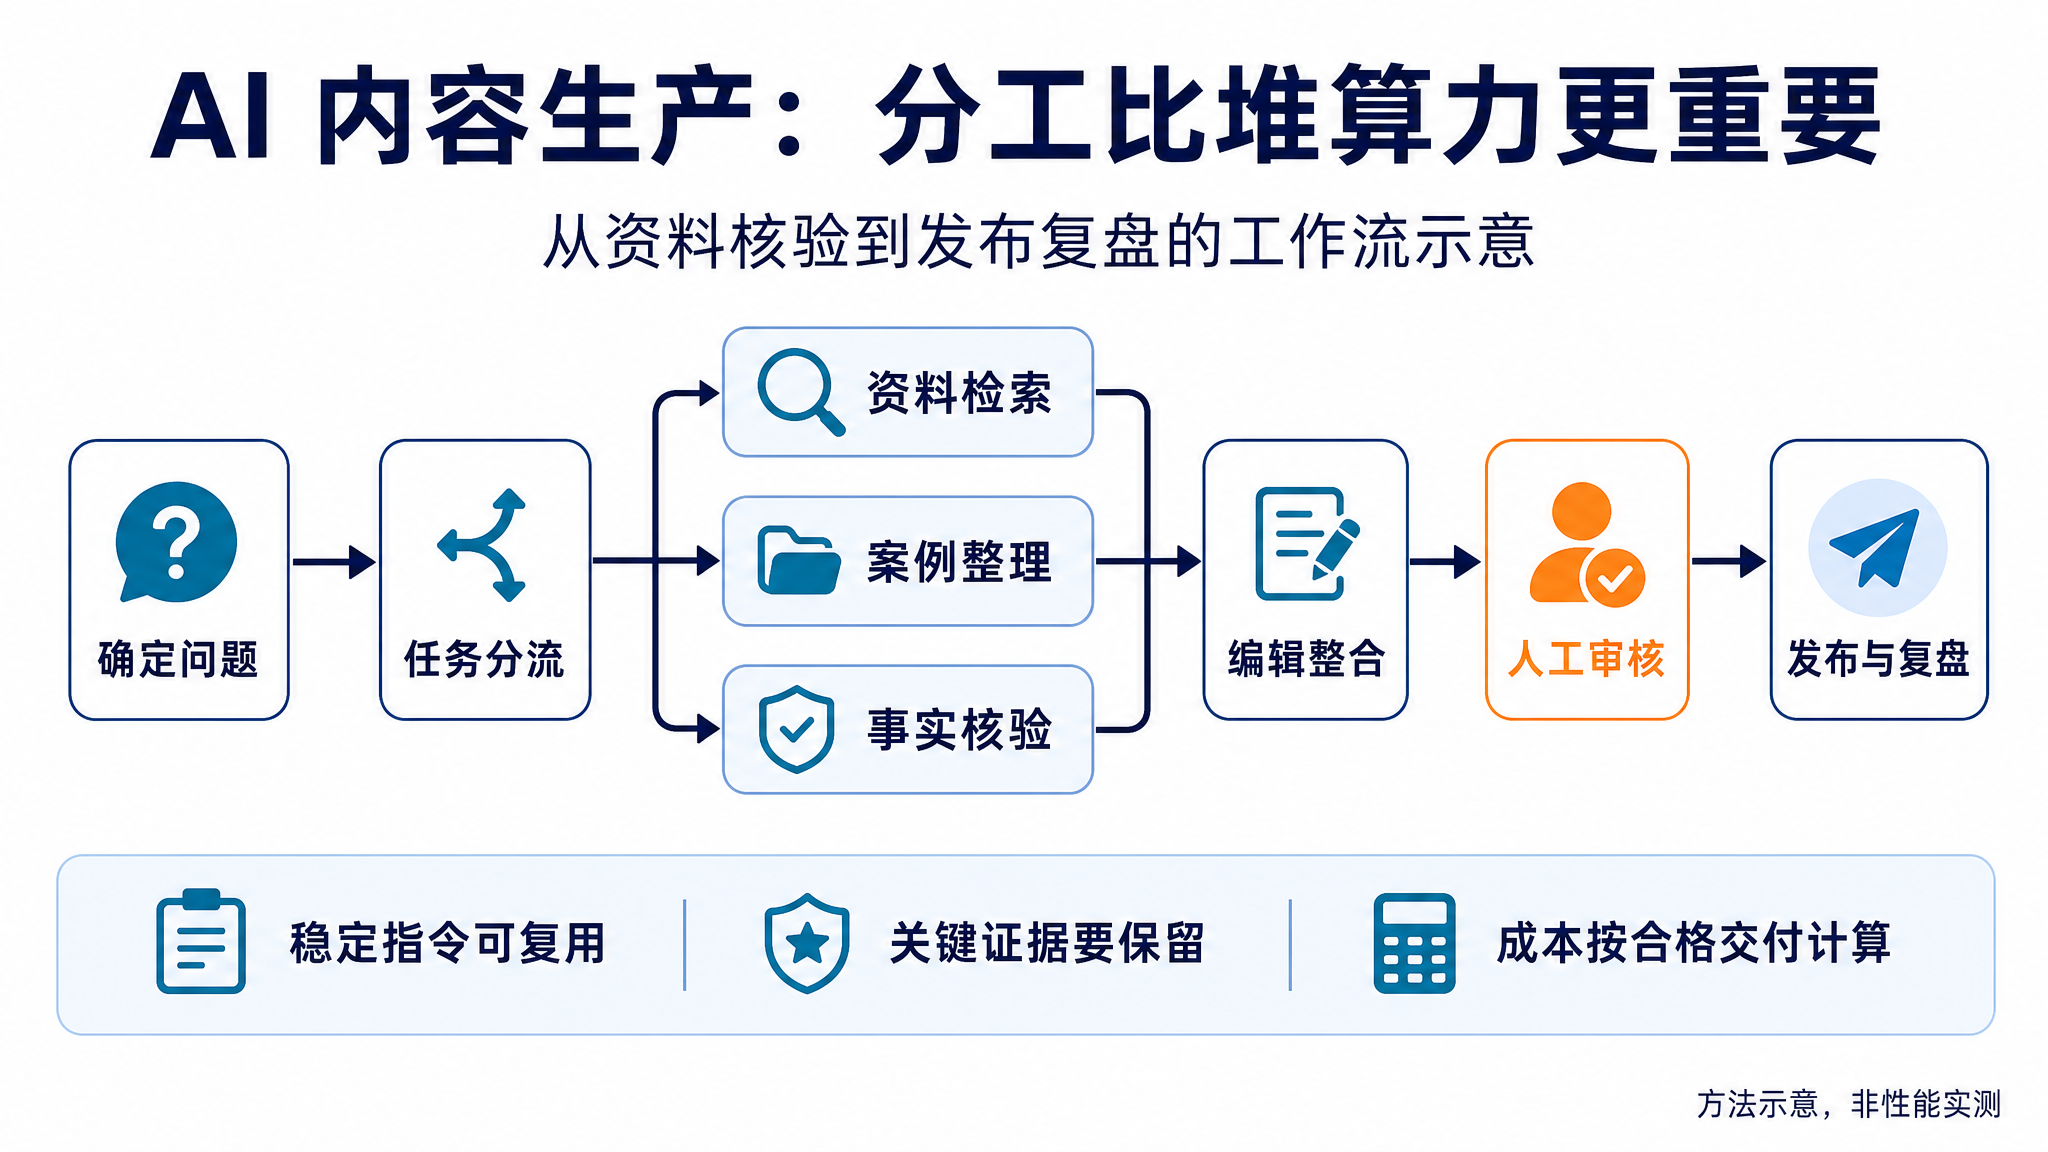
配图是流程示意,不是性能实测。事实核验既可以在资料阶段开展,也应在成稿后重新执行。
每个研究分支交付的最好不是一大段 prose,而是可以检查的结构:
{
  "claim": "某功能在当前版本处于 beta",
  "source_url": "https://example.com/official-doc",
  "evidence_excerpt": "支持结论的原文片段",
  "version_scope": "适用的产品和版本",
  "limitations": ["尚未验证当前接入渠道是否支持"],
  "status": "needs_review"
}
上面的 URL 是示例占位,不是证据。生产时必须填真实来源。
编排器还应负责:
- 限制并发数、工具次数和总预算;
- 给每个分支设置超时与停止条件;
- 对重复来源和重复结论去重;
- 标记冲突,禁止用“多数投票”把冲突抹掉;
- 在依赖任务完成前,不启动下游结论生成。
尤其要记住:三个 Agent 都引用同一篇错误文章,不是三份独立证据。
5. 上下文压缩之后,别把证据一起压没了
OpenAI 指南介绍了上下文压缩,用于减少长对话体积,同时保留继续任务所需状态。[1]
落到业务实现,我建议把“聊天历史”和“任务状态”分开。
聊天记录可以压缩,但以下状态最好单独持久化:
task_id
当前阶段与任务版本
已核验的主张 → 来源映射
未解决的冲突
成本与重试计数
人工审核状态
发布结果标识
一句“资料已经整理完”没法支持后续审核。你需要知道整理了什么、依据是什么、哪些结论还不能用。
权限也一样。查资料和保存草稿可以自动化;正式发布、删除线上文章、修改配置,应有明确的授权边界。
如果发布请求超时,不要直接再发一次。先查询是否已经成功,再决定是否重试,避免重复文章。任务标识、状态查询和幂等控制,比再优化一句提示词更实际。
6. 别只看 token 单价,看每次合格交付的成本
假设两个方案各生成 100 篇内容:
- 方案 A 的总费用低,但大量文章需要重写。
- 方案 B 调用价格稍高,首轮审核通过率更高。
不能只凭第一次生成的价格判断 A 更划算。
建议统计:
单篇合格内容成本 = 模型、工具、返工和人工审核的总成本 ÷ 合格文章数量
分母为 0 时应标记为无法交付,而不是继续算一个漂亮均价。
最小评估表可以包含:
| 指标 | 验证方法 |
|---|---|
| 事实错误率 | 对关键主张逐条核对来源 |
| 来源完整率 | 检查关键主张是否有可访问且相关的证据 |
| 首轮通过率 | 固定审核标准,统计无需大改的样本 |
| 单篇合格成本 | 把失败、重试和人工一起算进去 |
| P50 / P95 延迟 | 观察典型任务和尾部慢任务 |
| 发布后效果 | 追踪实际引用、访问和转化,避免混同 |
比较方案时,用同一批任务、相同验收标准和相近条件。不然很容易把题目难度变化当成模型优化。
7. GEO 最后还是要回到内容本身
早期 GEO 论文报告,在其评测设置下,优化方法可以带来最高约 40% 的可见性提升,同时指出不同领域效果不同。[4]
这不是“你的博客流量保底涨 40%”,更不能用来承诺某个模型写的文章一定被引用。
对开发者博客来说,更可控的做法是:
- 一篇文章回答一个具体问题,别用大标题掩盖空内容。
- 数字写清来源、计算方式和适用范围。
- 代码说明依赖、用途与限制,不把伪代码包装成生产方案。
- 关键结论保留为文字,不只放在图片里。
- 记录更新时间;产品规则变化时回头维护。
Google 也明确建议重要内容以文本形式呈现,结构化数据要与可见内容一致。[5]
说到底,GEO 不应该成为“为 AI 拼凑更多页面”的借口,而应该推动我们把答案和证据写得更清楚。
小结
如果你正在做一个 AI 内容工具,我建议按这个顺序优化:
先补证据和验收,再做任务路由,然后观察缓存,最后考虑多智能体。
简单任务不浪费算力,复杂任务不吝啬推理,外部事实有来源,发布操作有边界。这套工程基本功,往往比一上来就堆最强模型更值得投入。
你在实际项目里遇到的瓶颈,是调用费用、检索质量,还是人工审核太费时间?欢迎交流具体场景。
参考资料
- OpenAI:GPT-6 实践指南
- OpenAI:Introducing GPT-6.1 Sol
- Anthropic:How we built our multi-agent research system
- GEO: Generative Engine Optimization
- Google Search Central:AI features and your website
本文基于《GPT-6 时代做 GEO:别只追最强模型,把内容工作流搭对更重要》改写为开发实践版。配图由 GPT Image 2 生成。
评论
发表评论